최신 소식
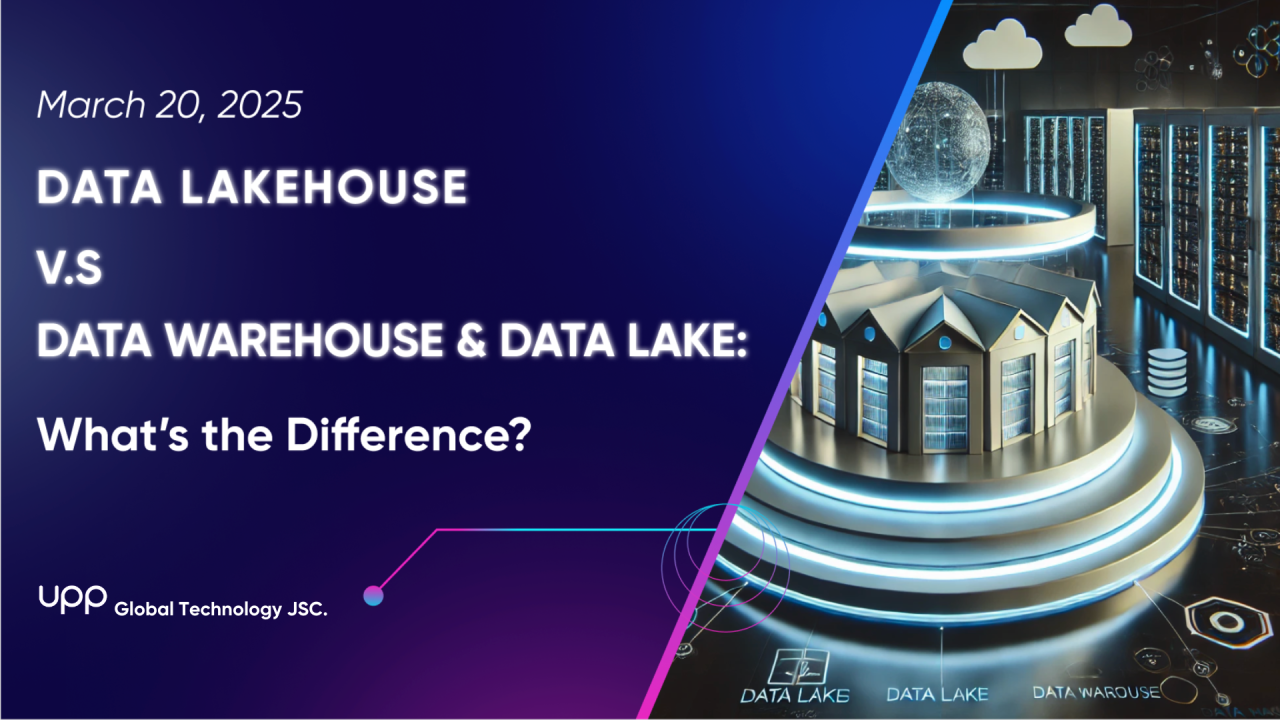
데이터 레이크하우스는 급변하는 데이터 환경 속에서 효율성과 유연성을 동시에 확보하기 위해 등장한 현대적인 데이터 아키텍처입니다. 기존 데이터 웨어하우스와 데이터 레이크가 가진 비용, 운영, 통합의 한계를 보완하며 다양한 워크로드를 하나의 플랫폼에서 처리할 수 있도록 설계되었습니다.
레이크하우스는 여러 시스템으로 분리된 데이터 사일로(Silo) 문제를 해소하고, 저장부터 관리와 분석까지 전 과정을 통합합니다. 또한 대규모 데이터를 빠르게 처리할 수 있으며, 머신러닝(ML)과 인공지능(AI) 같은 고급 분석에도 뛰어난 확장성을 제공합니다.
1. 데이터 레이크와 데이터 웨어하우스 이해하기
데이터 레이크하우스를 이해하기 전에, 데이터 웨어하우스와 데이터 레이크에 대해 먼저 이해하는 것이 중요합니다. 데이터 웨어하우스는 비즈니스 인텔리전스 애플리케이션과 데이터 분석 분야에서 오랜 역사를 가지고 있습니다. 이는 다양한 소스로부터 구조화된 데이터를 저장, 관리, 분석하기 위한 중앙 저장소 역할을 합니다.
-
데이터 웨어하우스: 구조화된 데이터를 저장, 관리, 분석하기 위한 중앙 저장소입니다. ETL(추출, 변환, 적재) 프로세스를 통해 데이터를 일관된 형식으로 변환한 뒤 적재하므로, 대시보드 생성과 기업 보고서 작성에 적합합니다.
-
한계: 구축 및 운영 비용이 높을 수 있고, 반정형 데이터나 비정형 데이터를 처리하는 데에는 제약이 있습니다.
-
데이터 레이크: 구조화된 데이터, 반정형 데이터, 비정형 데이터를 포함한 모든 유형의 데이터를 원시 형식 그대로 저장할 수 있는 스토리지 시스템입니다.
-
장점: 사전에 정의된 스키마가 필요하지 않아 저장 비용이 낮고 유연성이 높으며, 데이터 사이언스와 머신러닝 작업에 적합합니다.
-
한계: 트랜잭션 지원, 데이터 품질 관리, 데이터 구조의 일관성 보장 측면에서는 데이터 웨어하우스보다 부족할 수 있습니다.
이러한 특성 덕분에 데이터 레이크는 오디오, 비디오, 텍스트 등 다양한 형태의 데이터를 저장할 수 있으며, 유연성이 높아 데이터 사이언스나 머신러닝 작업에 적합합니다. 하지만 그만큼 데이터 웨어하우스에서 일반적으로 제공되는 몇 가지 핵심 기능들. 예를 들어 트랜잭션 지원, 데이터 품질 관리, 데이터 구조의 일관성 보장은 부족한 단점이 있습니다.
2. 데이터 레이크하우스란 무엇인가?
데이터 레이크하우스는 이후 등장하여 데이터 레이크와 데이터 웨어하우스의 장점을 결합함으로써 더 나은 데이터 관리 시스템을 형성하였습니다. 이는 데이터 레이크처럼 대용량의 원시 데이터를 저렴한 비용으로 저장할 수 있으면서도, 데이터 웨어하우스처럼 데이터를 조직화하고 관리할 수 있도록 해줍니다.

과거에는 기업들이 구조화된 데이터를 비즈니스 인텔리전스에 활용하기 위해 데이터 웨어하우스를 사용하고, 비정형 또는 반정형 데이터를 머신러닝 및 빅데이터 분석에 활용하기 위해 데이터 레이크를 사용하였습니다. 그러나 이 두 시스템 간에 데이터를 이동시키는 과정에서 복잡성, 높은 비용, 데이터 일관성 문제 등이 발생하였습니다.
데이터 레이크하우스는 이러한 문제를 해결하기 위해 웨어하우스와 유사한 기능을 제공하면서도, 데이터 레이크의 저비용 저장과 유연성을 결합합니다. 이를 통해 기업은 대용량 데이터를 보다 효율적으로 저장하고 접근할 수 있으며, 데이터 품질 문제를 줄일 수 있습니다.
그 결과, 데이터 관리는 더욱 단순해지고, 중복 데이터가 감소하며, 실시간 데이터 분석이 가능해집니다.
3. 데이터 레이크하우스의 주요 특징
데이터 레이크하우스는 데이터 저장, 관리, 처리 기능을 통합한 솔루션으로, 구조화·반정형·비정형 데이터를 하나의 스토리지 시스템에서 처리할 수 있습니다.
-
통합 저장소: 다양한 유형의 데이터를 하나의 플랫폼에서 관리하여 여러 시스템 운영 부담을 줄입니다.
-
데이터 품질과 거버넌스: 보안, 품질 관리, 거버넌스 기능을 통해 신뢰할 수 있는 데이터를 유지합니다.
-
ACID 트랜잭션: 여러 사용자가 동시에 접근하더라도 데이터의 정확성과 일관성을 지원합니다.
-
오픈 포맷 지원: Parquet, Iceberg 등 표준화된 데이터 포맷을 활용해 다양한 도구와 호환됩니다.
-
실시간 처리: 데이터를 즉시 수집하고 분석해 빠른 의사결정을 가능하게 합니다.
-
확장 가능한 아키텍처: 저장소와 컴퓨팅을 분리하여 성능과 비용 효율성을 높입니다.
4. 데이터 레이크하우스를 가능하게 하는 주요 기술
데이터 레이크하우스의 개발은 메타데이터 계층, 고성능 쿼리 엔진, 데이터 사이언스 및 머신러닝 작업에 최적화된 접근 방식을 포함한 여러 주요 기술 발전에 의해 추진되었습니다. 이러한 혁신들은 데이터 레이크하우스가 데이터 레이크의 확장성에 전통적인 데이터 웨어하우스의 성능과 신뢰성을 결합할 수 있게 합니다.

4.1 메타데이터 계층
델타 레이크(Delta Lake), 아파치 아이스버그(Apache Iceberg), 후디(Hudi)와 같은 메타데이터 계층은 데이터 레이크하우스 내에서 데이터를 관리하는 데 중요한 역할을 합니다. 이러한 계층은 Parquet, ORC와 같은 오픈 파일 포맷 위에 위치하여 ACID 준수 트랜잭션, 스키마 강제 적용 및 진화, 타임 트래블 기능 등의 필수 기능을 제공합니다.
메타데이터 계층은 스트리밍 I/O를 지원하여 Kafka와 같은 외부 메시징 시스템이 필요 없도록 하여 실시간 데이터 수집을 가능하게 합니다. 또한, 데이터 검증과 인덱싱을 효율적으로 수행하여 구조화된 데이터와 반정형 데이터 모두를 일관성 있고 무결성 있게 관리할 수 있도록 합니다.
4.2 고성능 쿼리 엔진
데이터 레이크의 역사적인 성능 한계를 해결하기 위해, 현대의 데이터 레이크하우스는 Apache Spark, Presto, Trino와 같은 고급 쿼리 엔진을 활용합니다. 이러한 엔진들은 벡터화 실행과 같은 최적화를 통해 처리 효율성을 개선합니다. 벡터화 실행은 SIMD(Single Instruction, Multiple Data)를 통해 여러 행을 동시에 처리하여 성능을 높입니다.
또한, 자주 액세스되는 데이터를 RAM이나 SSD에 캐시하여 디스크 I/O 병목 현상을 최소화하고 쿼리 성능을 크게 향상시킵니다. 적응형 쿼리 실행(AQE)는 실행 계획을 런타임 통계에 따라 동적으로 조정하며, Parquet와 ORC와 같은 열 지향 저장 포맷은 저장소에서 읽는 데이터 양을 줄여줍니다. 이러한 발전 덕분에 데이터 레이크하우스는 전통적인 MPP(대규모 병렬 처리) 데이터 웨어하우스와 비교할 수 있는 속도로 복잡한 분석 쿼리를 실행할 수 있습니다.
4.3 머신러닝 및 데이터 사이언스 지원
데이터 레이크하우스는 데이터 사이언스 및 머신러닝 작업 부하에 최적화된 접근을 제공하여 복잡한 ETL 파이프라인의 필요성을 제거합니다. 오픈 데이터 포맷을 지원함으로써, 데이터 레이크하우스는 TensorFlow, PyTorch, Scikit-learn과 같은 머신러닝 프레임워크에서 직접 데이터를 액세스할 수 있게 합니다.
Spark DataFrames와 Dask와 같은 분산 처리 프레임워크는 대규모 데이터 변환 및 특성 공학을 가능하게 합니다. 또한, 데이터 레이크하우스는 효율적인 인덱싱과 파티셔닝을 활용하여 모델 학습 및 추론을 가속화합니다. 특성 저장소는 머신러닝 특성의 중앙 집중식 저장소와 버전 관리를 제공하여, 머신러닝 워크플로우에서 재현성과 일관성을 더욱 강화합니다.
전반적으로 데이터 레이크하우스는 데이터 아키텍처에서 중요한 발전을 나타내며, 데이터 레이크와 데이터 웨어하우스 간의 격차를 메웁니다. 구조화된 데이터와 비정형 데이터를 처리할 수 있는 능력과 고성능 쿼리 실행, 네이티브 머신러닝 통합을 결합하여 현대의 데이터 기반 기업에 강력한 솔루션을 제공합니다.
5. 데이터 레이크하우스 vs 데이터 웨어하우스 vs 데이터 레이크 비교
5.1 데이터 레이크하우스의 장점
데이터 레이크하우스는 기업에 많은 이점을 제공합니다.
-
데이터 관리 간소화: 데이터 웨어하우스와 데이터 레이크 기능을 하나의 시스템으로 결합하여 데이터 사일로와 플랫폼 간 데이터 이동을 줄입니다.
-
데이터 품질 개선: 데이터를 체계적으로 조직하고 규칙을 적용하여 신뢰할 수 있는 분석 데이터를 유지합니다.
-
비용 절감: 원시 데이터를 저비용 클라우드 저장소에 보관하고 중복 데이터와 불필요한 처리 과정을 줄입니다.
-
데이터 신뢰성 향상: 데이터를 하나의 시스템에서 관리하여 오류, 불일치, 데이터 손실 가능성을 낮춥니다.
-
다양한 워크로드 지원: BI, 머신러닝, 빅데이터 분석, 실시간 쿼리 등 여러 분석 목적에 활용할 수 있습니다.
| 구분 | 데이터 웨어하우스 | 데이터 레이크 | 데이터 레이크하우스 |
|---|---|---|---|
| 데이터 유형 | 구조화된 데이터만 저장 | 모든 형태의 데이터(원시 데이터 포함) 저장 | 구조화된 데이터 + 원시 데이터 모두 저장 |
| 처리 방식 | 저장 전에 데이터를 처리해야 함 (ETL 필요) | 원시 데이터를 저장하고 이후에 처리 | 원시 데이터와 처리된 데이터를 모두 지원 |
| 속도 | ETL 처리로 인해 상대적으로 느림 | 데이터 적재 속도는 빠르지만 분석은 어려움 | 빠른 데이터 적재와 유연한 쿼리 가능 |
| 유연성 | 구조화된 데이터만 다뤄 유연성이 낮음 | 매우 유연하지만 관리가 복잡함 | 유연하면서도 사용이 용이함 |
| 비용 | 처리 및 저장 비용이 높음 | 상대적으로 저렴하지만 전문 기술 필요 | 효율적인 관리로 비용 대비 효과가 높음 |
| 적합한 용도 | 비즈니스 인텔리전스(BI) 및 리포팅 | 빅데이터, 머신러닝, 인공지능(AI) | BI, 빅데이터, 머신러닝, 인공지능(AI) |
5.2 데이터 레이크하우스의 응용
오늘날 많은 기업들이 데이터 관리 및 분석을 위해 데이터 레이크하우스 기술을 채택하고 있습니다. 예를 들어, Amazon Redshift Spectrum은 기업들이 데이터를 이동하거나 복사하지 않고도 Amazon S3에 저장된 데이터를 분석할 수 있게 해줍니다. 이를 통해 데이터 처리 속도가 빨라지고 효율성이 향상됩니다.
베트남에서는 Elcom의 Data360X가 데이터 레이크하우스 아키텍처를 사용하는 훌륭한 예입니다. Data360X는 기업들이 데이터를 효율적으로 관리하고 분석할 수 있도록 도와줍니다. 데이터 레이크하우스를 사용하여 Data360X는 데이터를 비용 효율적인 방식으로 저장, 조직 및 처리할 수 있습니다.
Data360X의 가장 중요한 이점은 다음과 같습니다.
-
중앙 집중식 데이터 관리: 여러 출처의 데이터를 하나의 플랫폼에 통합하여 일관성과 정확성을 보장합니다.
-
유연한 분석: BI, 예측 분석, 머신러닝, 빅데이터 처리를 지원합니다.
-
비용 최적화: 확장 가능한 클라우드 기반 저장소를 사용하여 운영 비용을 절감합니다.
데이터 레이크하우스 솔루션을 채택함으로써 기업들은 데이터의 잠재력을 완전히 활용하고 더 나은 인사이트를 얻으며 디지털 시대에서 경쟁력을 유지할 수 있습니다.
6. 결론
데이터 레이크하우스는 데이터 레이크의 유연성과 데이터 웨어하우스의 구조적 조직을 결합한 고급 데이터 아키텍처입니다. 이는 기업들이 모든 유형의 데이터를 하나의 시스템에서 저장, 관리 및 분석할 수 있도록 돕습니다.
확장성, 비용 효율성, 강력한 데이터 관리 기능을 갖춘 데이터 레이크하우스는 데이터 기반 의사 결정을 최적화하려는 기업에 이상적인 솔루션입니다. 더 많은 기업들이 빅 데이터와 AI를 채택함에 따라 데이터 레이크하우스의 채택은 증가할 것으로 예상되며, 이는 데이터 관리의 미래에 있어 중요한 기술이 될 것입니다.
Newsletter
더 보기




























대화하기
원하신 정보를 이메일로 보내드립니다


이메일을 입력해 주세요
원하시는 내용을 입력해 주세요


Hanoi, Vietnam
Web3 Tower, No. 15, Alley 4, Duy Tan, Cau Giay, Hanoi, Vietnam